В марте этого года клиент позвонил с проблемой, которая звучала как дежурная: «Менеджеры говорят, что заявки с сайта приходят через раз». Сайт на WordPress, форма на Contact Form 7, интеграция с Битрикс24 через популярный плагин. Полез смотреть — и нашёл классику: плагин отправлял лиды синхронным POST-запросом прямо из обработчика формы, а портал Битрикс24 в час пик отвечал по 8–10 секунд. Часть запросов просто умирала по таймауту PHP. За месяц потерялось 47 заявок из 612 — почти 8% лидов ушло в никуда при полностью «рабочей» интеграции.
Тот случай стал поводом пересмотреть, как я вообще строю передачу лидов с сайта в CRM. За последние пару лет я собрал все три основных подхода на реальных проектах: прямые вебхуки, поллинг через cron и очередь сообщений. У каждого есть своя ниша, и выбор «не так» стоит клиенту либо денег, либо заявок. Разберу все три с кодом, цифрами и тем, где каждый ломается.
Что вообще должна уметь интеграция
Прежде чем сравнивать, зафиксирую требования, которые я считаю обязательными в 2026 году:
- Ни одна заявка не теряется. Если CRM недоступна, лид ждёт, а не испаряется.
- Пользователь не ждёт CRM. Отправка формы должна занимать меньше секунды независимо от того, жив портал или нет.
- Идемпотентность. Повторная отправка того же лида не создаёт дубль в CRM. Когда я писал про интеграцию Telegram-ботов с CRM, там та же история: без ключа идемпотентности ретраи превращают базу в помойку.
- Наблюдаемость. В любой момент видно: сколько лидов отправлено, сколько упало, какой ответила CRM.
Дальше оцениваю каждый подход именно по этим четырём пунктам.
Подход 1: прямой вебхук из обработчика формы
Самый популярный вариант, потому что он очевидный: форма отправлена → тут же дёргаем REST API CRM. Примерно так это выглядит на WordPress:
add_action('wpcf7_mail_sent', function ($form) {
    $data = WPCF7_Submission::get_instance()->get_posted_data();
    $response = wp_remote_post('https://portal.bitrix24.ru/rest/1/KEY/crm.lead.add.json', [
        'timeout' => 5,
        'body' => json_encode(['fields' => [
            'TITLE' => 'Заявка с сайта',
            'NAME'  => $data['your-name'],
            'PHONE' => [['VALUE' => $data['tel'], 'VALUE_TYPE' => 'WORK']],
        ]]),
        'headers' => ['Content-Type' => 'application/json'],
    ]);
});
Три строчки — и интеграция «готова». Именно так работает большинство плагинов, и именно так был устроен плагин у клиента из вступления.
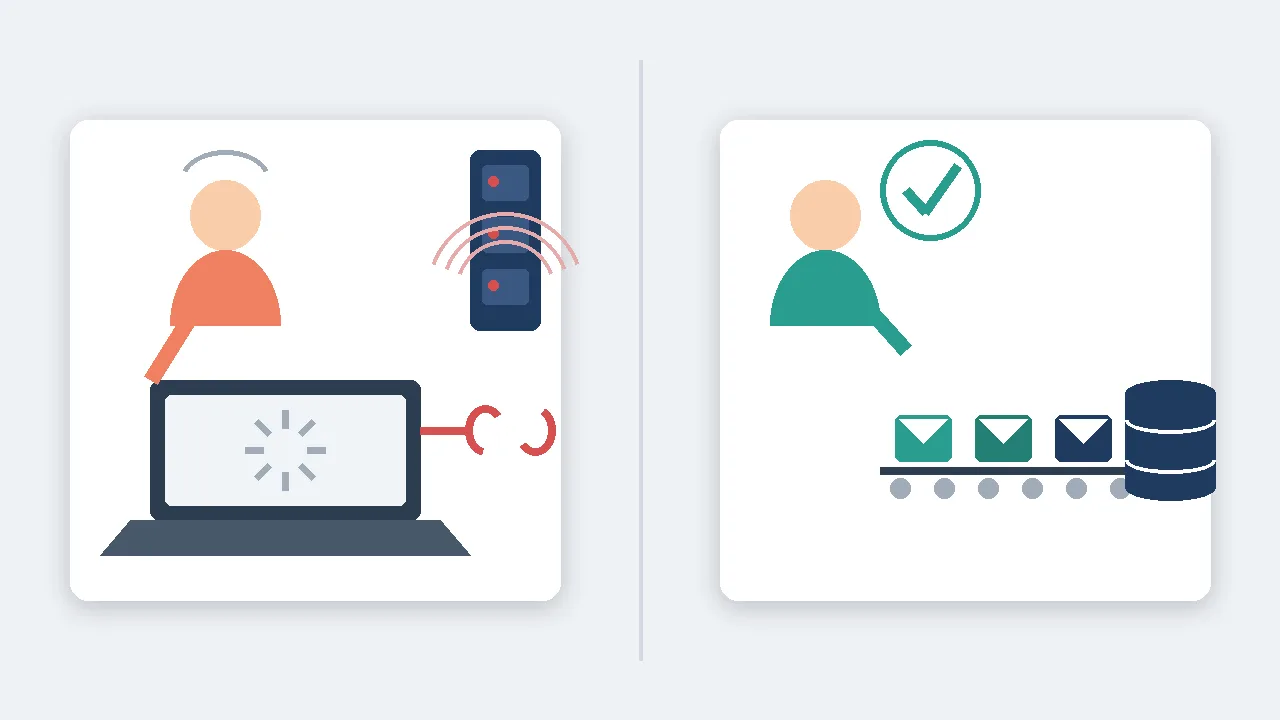
Где ломается. Во-первых, таймауты. Битрикс24 по SLA отвечает быстро, но в реальности я видел p95 в 6–8 секунд на порталах с сотней пользователей и тяжёлыми бизнес-процессами на создание лида. PHP-FPM-воркер всё это время висит, пользователь смотрит на крутилку, а при timeout=5 часть запросов умирает. Во-вторых, ретраи: если CRM вернула 500 или сеть моргнула, заявка потеряна — обработчик уже отработал, форма уже сказала «спасибо». В-третьих, блокировки: 20 одновременных отправок формы × 8 секунд ожидания = все воркеры PHP-FPM заняты, сайт лёг для остальных посетителей. Я видел это вживую на распродаже у клиента с WooCommerce.
Когда это нормальный выбор. Малый трафик (до 20–30 заявок в день), CRM с гарантированно быстрым API, и вы готовы смириться с потерей доли процента заявок. Для лендинга стоматологии — приемлемо. Для интернет-магазина с платным трафиком — нет.
Кстати, если вы всё же идёте этим путём с Битрикс24, я подробно разбирал вебхуки и REST API Битрикс24 без плагинов — там про входящие вебхуки, лимиты и права.
Подход 2: поллинг — сайт складывает, cron забирает
Второй вариант: форма пишет лид в локальную таблицу (или CPT, или хоть в файл), а отдельный cron-процесс раз в минуту забирает пачку и отправляет в CRM. Сайт вообще не общается с CRM синхронно.
Минимальная схема на WordPress:
// 1. Сохраняем лид локально — это занимает миллисекунды
add_action('wpcf7_mail_sent', function ($form) {
    $data = WPCF7_Submission::get_instance()->get_posted_data();
    global $wpdb;
    $wpdb->insert('wp_lead_queue', [
        'payload'    => json_encode($data, JSON_UNESCAPED_UNICODE),
        'status'     => 'pending',
        'created_at' => current_time('mysql'),
    ]);
});

// 2. WP-Cron раз в минуту отправляет пачку
add_action('lead_queue_flush', function () {
    global $wpdb;
    $leads = $wpdb->get_results(
        "SELECT * FROM wp_lead_queue WHERE status = 'pending' LIMIT 20"
    );
    foreach ($leads as $lead) {
        $ok = send_to_bitrix24(json_decode($lead->payload, true), $lead->id);
        $wpdb->update('wp_lead_queue',
            ['status' => $ok ? 'sent' : 'failed', 'attempts' => $lead->attempts + 1],
            ['id' => $lead->id]
        );
    }
});
Ключевая деталь — $lead->id как ключ идемпотентности: передаём его в CRM в отдельном поле (в Битрикс24 удобно использовать UF_CRM_* или SOURCE_DESCRIPTION), а перед созданием лида проверяем, нет ли уже лида с таким ключом. Тогда даже если cron отработал дважды, дубля не будет.
Цифры с реального проекта. Интернет-магазин запчастей, ~180 заявок в день, Битрикс24. Перевёл их с плагина на поллинг в феврале 2026-го. Время ответа формы упало с 2,8 до 0,4 секунды (перестали ждать CRM), потерянные заявки — с ~5% до нуля за три месяца наблюдений. Задержка доставки лида менеджеру — максимум 60–90 секунд, что для продаж запчастей некритично.
Где ломается. Во-первых, задержка: если у вас колл-центр, который перезванивает за 30 секунд, минута ожидания — это потерянная конверсия. Во-вторых, WP-Cron ненадёжен сам по себе: он срабатывает только при заходах на сайт. Лечится системным cron, который дёргает wp-cron.php каждую минуту, — но это уже шаг к DevOps, который не каждому клиенту продаёшь. В-третьих, таблица растёт: без чистки старых записей через полгода там сотни тысяч строк.
Когда выбирать. Средний трафик, допустима задержка в минуту-две, нет возможности поднять брокер сообщений. По соотношению «надёжность / сложность внедрения» это мой дефолт для большинства клиентских проектов на WordPress и Битриксе.
Подход 3: очередь сообщений (RabbitMQ, Redis Streams)
Тяжёлая артиллерия: форма публикует событие в брокер, отдельный воркер-потребитель читает очередь и отправляет в CRM с ретраями, dead-letter queue и экспоненциальным backoff’ом.
С Redis Streams продюсер — это три строки:
$redis->xAdd('leads', '*', [
    'name'  => $data['your-name'],
    'phone' => $data['tel'],
    'ts'    => time(),
]);
Воркер на PHP или Python читает через XREADGROUP, подтверждает через XACK, а неподтверждённые сообщения после N попыток уезжают в отдельный стрим — аналог DLQ. В RabbitMQ это всё из коробки: подтверждения, повторные доставки, мёртвые очереди.
Что это даёт на практике. На проекте с лидами из четырёх источников (два сайта, лендинг и Telegram-бот) мы подняли RabbitMQ, и это решило сразу три проблемы: единая точка входа для всех лидов, ретраи с backoff’ом при деградации CRM (портал лежал 40 минут — ни один лид не потерялся, все доехали после восстановления) и честная метрика «сколько лидов в полёте» прямо из дашборда брокера.
Где ломается. В вас. Точнее, в эксплуатации: брокер надо ставить, мониторить, бэкапить, обновлять. На shared-хостинге это невозможно в принципе — нужен VPS. Я видел проект, где RabbitMQ съедал 1,2 ГБ RAM на очереди из десяти сообщений в день, потому что «так было в туториале». Для 30 заявок в день это пушка по воробьям и лишние 500–1000 рублей в месяц за сервер плюс часы на поддержку.
Когда выбирать. Несколько источников лидов, жёсткие требования к доставке (медицина, финансы, дорогая контекстная реклама), трафик от сотен заявок в день, есть кто-то, кто будет за этим смотреть. Или когда очередь уже есть в инфраструктуре для других задач — тогда докинуть туда лиды почти бесплатно.
Сравнение в цифрах
Собрал всё в одну таблицу по итогам проектов последних двух лет:
| Критерий | Прямой вебхук | Поллинг (cron) | Очередь сообщений |
|---|---|---|---|
| Время ответа формы | 2–8 с (зависит от CRM) | 0,3–0,5 с | 0,3–0,5 с |
| Задержка доставки в CRM | секунды | 1–2 мин | секунды |
| Потеря лидов при падении CRM | да, теряются | нет | нет |
| Идемпотентность | нужно писать руками | простая (ключ из БД) | простая (message id) |
| Порог внедрения | вечер | 1–2 дня | от недели с эксплуатацией |
| Требования к хостингу | любой shared | shared + системный cron | VPS |
| Разумный трафик | до 30 заявок/день | до нескольких сотен | сотни+ и мультиисточник |
Мониторинг: как узнать о проблеме раньше клиента
История из вступления научила меня ещё одному: клиент замечает потерю заявок последним, обычно по косвенным признакам вроде «что-то продажи просели». Поэтому на любой интеграции, кроме самой примитивной, я ставлю два дешёвых контроля.
Первый — счётчик несостыковки. Раз в сутки простой скрипт сравнивает количество отправленных форм на сайте с количеством созданных лидов в CRM за тот же период (у Битрикс24 это crm.lead.list с фильтром по дате и источнику). Расхождение больше 2% — письмо мне. На поллинг-схеме это вообще бесплатно: всё уже лежит в таблице wp_lead_queue, достаточно сравнить COUNT(*) по статусам.
Второй — heartbeat-лид. Раз в день cron отправляет тестовую заявку с пометкой «тест» прямо через боевой пайплайн и проверяет, что она появилась в CRM в течение пяти минут. Если нет — алерт. Это ловит не только падения, но и тихие поломки вроде протухшего токена вебхука или смены прав у пользователя интеграции. Оба контроля — это полдня работы один раз, а спасают репутацию регулярно.
Мой текущий дефолт
Если коротко: я больше не ставлю плагины «форма → CRM» с синхронной отправкой ни на один проект, где за заявку платят деньгами за трафик. Даже когда клиент экономит, я закладываю поллинг-таблицу — это плюс день работы, но снимает целый класс ночных звонков. А очередь сообщений предлагаю только тогда, когда у клиента уже есть VPS и хотя бы минимальное администрирование, либо когда источников лидов больше двух.
Отдельная боль — спам: какую бы архитектуру вы ни выбрали, мусорные заявки будут долетать до CRM и раздражать менеджеров. Я уже писал, почему против CAPTCHA и что работает вместо неё — honeypot плюс серверная валидация отсекают 95% ботов до того, как лид вообще попадёт в очередь.
А как устроена передача заявок на ваших проектах — доживают лиды до CRM гарантированно или вы тоже однажды обнаружили «пропавшие» заявки по случайности? Было бы интересно сравнить подходы.
