Пятница, 11:47, день старта распродажи у клиента с интернет-магазином на WooCommerce. Я был на созвоне, когда в чат упало сообщение от владельца: «Сайт лёг». Мониторинг показывал 502 на всех страницах каталога, а нагрузка на базу данных ушла в 40 с лишним одновременных запросов на соединение. Ирония в том, что за три дня до этого мы как раз «ускоряли» сайт: поставили Redis и включили постоянный объектный кэш. Именно этот шаг и уронил магазин в самый важный день квартала. Разбираю, что пошло не так, как мы поднимали сайт за 40 минут и какие выводы я теперь вшиваю в каждый проект с кэшированием.
Что было настроено перед инцидентом
Исходные данные: WooCommerce, около 4 800 товаров, тема на конструкторе, 34 активных плагина. Хостинг — VPS с 4 ГБ RAM, PHP 8.3-FPM, MariaDB 10.11. Жалобы были стандартные: страница категории грузится 3–4 секунды, корзина подтормаживает. Разумное решение — включить объектный кэш, чтобы не дёргать базу на каждый чих. Мы поставили Redis 7.2 и подключили его через Redis Object Cache с настройками «по умолчанию из ридми».
Первые два дня всё выглядело отлично: TTFB категорий упал с 2,1 до 0,6 секунды, нагрузка на MariaDB снизилась раза в три. Я даже записал проект в «успешные». А потом наступила пятница.
Что случилось в день распродажи
В 11:40 стартовала email-рассылка на 28 тысяч подписчиков. Через семь минут сайт ушёл в 502. Картина на сервере была такая: Redis занял всю доступную ему память и начал вытеснять ключи по политике allkeys-lru. Вытеснение шло прямо под нагрузкой, и в какой-то момент из кэша вылетели транзиенты с данными о скидочных правилах и составе категорий. WooCommerce честно пошёл пересчитывать их в базу — но теперь это делали одновременно сотни процессов, потому что трафик с рассылки рос.
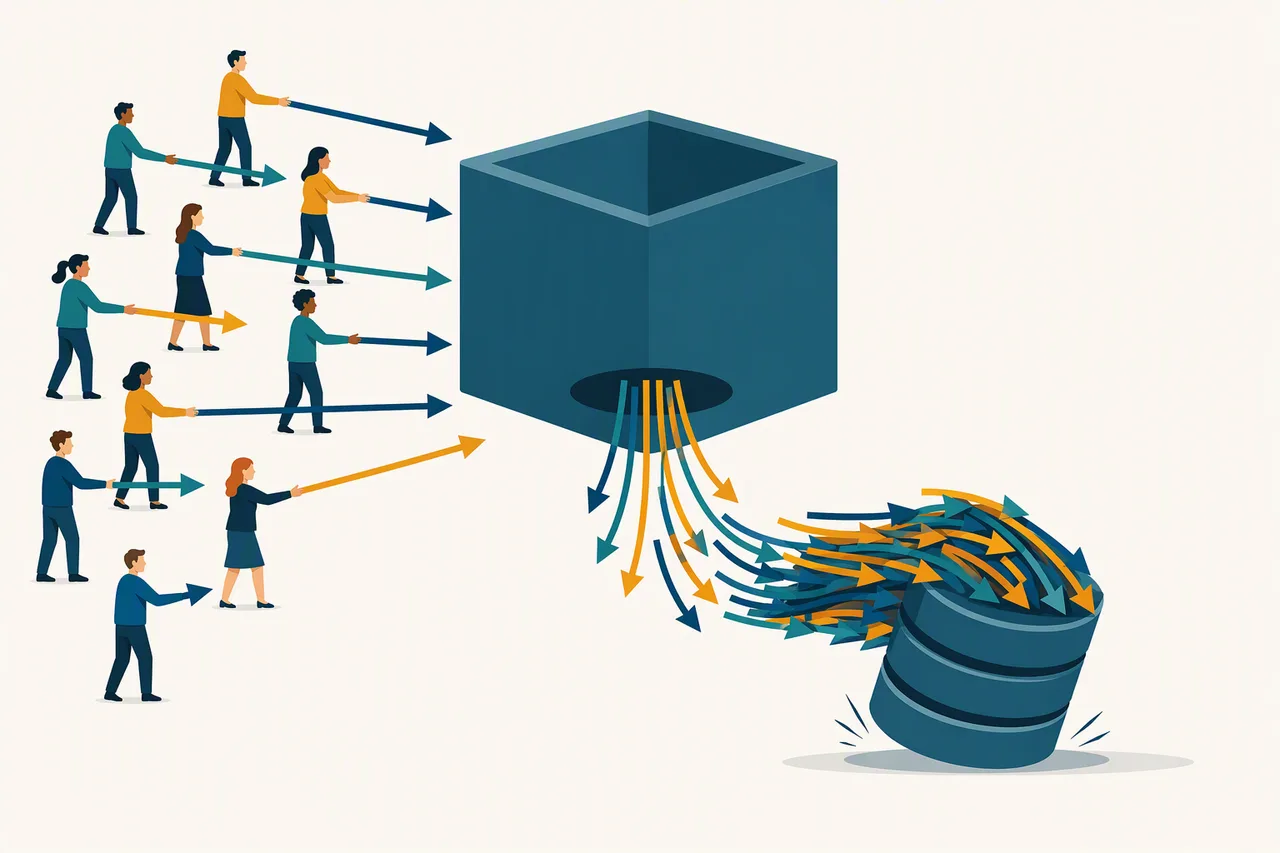
Классический cache stampede: один промах кэша по тяжёлому ключу порождает десятки параллельных пересчётов одного и того же. MariaDB уперлась в лимит соединений, PHP-FPM — в лимит воркеров, nginx начал отдавать 502. Сайт не просто замедлился — он умер полностью, включая главную, которая вообще-то отдавалась из страничного кэша, потому что страничный кэш тоже инвалидировался через тот же Redis.
Как отличить stampede от обычной перегрузки
Пока мы восстанавливали сайт, я по логам понял: stampede видно заранее, если знать, куда смотреть. Три маркера из slow query log и статистики Redis в тот день.
Первый — одинаковые тяжёлые запросы пачками. В slow query log за минуту до падения один и тот же запрос к wp_term_relationships с джойнами по товарам категории встречался 23 раза с разницей в миллисекунды. При нормальной работе такого не бывает: первый процесс кладёт результат в кэш, остальные забирают готовое. Пачка одинаковых запросов — верный признак, что кэш-промах обрабатывается параллельно.
Второй — метрики Redis. Команда INFO stats показывала evicted_keys, растущий на сотни в секунду, и hit rate, просевший с 96% до 61%. Вытеснение под нагрузкой плюс падающий hit rate — это почти всегда предвестник лавины промахов.
Третий — рост активных соединений MariaDB без роста реального трафика. График в панели хостера показывал, что число одновременных соединений удвоилось за четыре минуты, а число уникальных посетителей росло плавно. Значит, дело не в трафике, а в том, что каждый запрос стал жить дольше и плодить параллельные пересчёты.
Если у вас есть мониторинг, который смотрит хотя бы на эти три вещи, stampede ловится за минуты до того, как ляжет сайт. У нас мониторинг смотрел только на «сайт отвечает / не отвечает» — после этого случая добавил алерты на evicted_keys и количество соединений к базе.
Три ошибки, которые всё это вызвали
Когда мы откатили изменения и подняли сайт, я разобрал логи и конфиги. Ошибок было ровно три, и все — мои.
Первая: Redis без лимита памяти и без выделенного инстанса. В конфиге не стоял maxmemory, поэтому Redis съедал всё, что ему отдадут, а потом начинал вытеснять ключи в самый неподходящий момент. Хуже того, в том же инстансе лежали и объектный кэш, и страничный кэш, и сессии — падение одного утаскивало остальное. Правильная схема для такого проекта: отдельный инстанс (или хотя бы отдельная логическая база) под объектный кэш, maxmemory 512mb и политика volatile-lru, чтобы вытеснялись только ключи с TTL, а вечные транзиенты не пострадали.
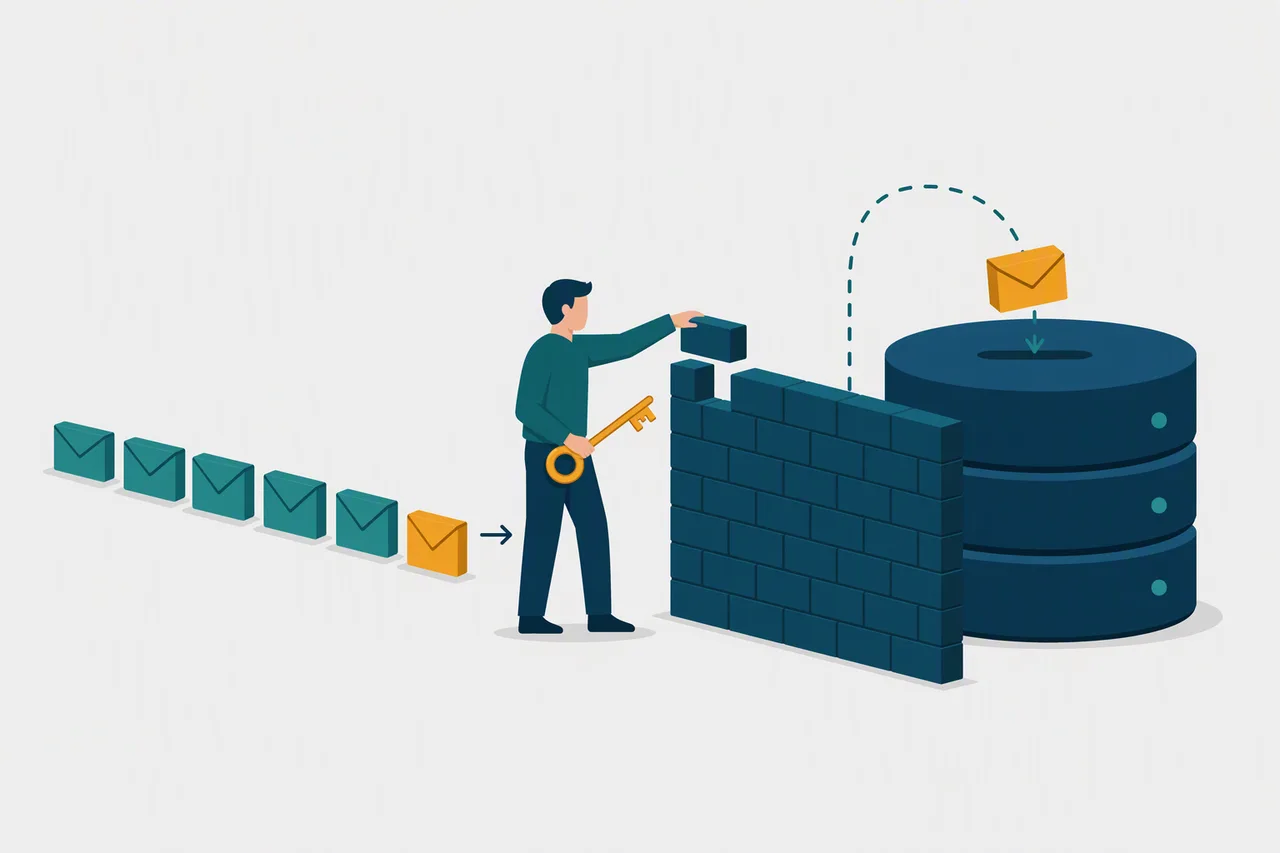
Вторая: никакой защиты от stampede. Дорогие пересчёты — скидочные правила, состав категорий, меню — не были защищены ни блокировками, ни упреждающим прогревом. В Redis Object Cache из коробки нет механизма «один пересчитывает, остальные ждут». Минимальный паттерн, который теперь ставлю всегда:
function get_category_products_cached($term_id) {
    $key = "cat_products_{$term_id}";
    $data = wp_cache_get($key, 'catalog');
    if (false !== $data) {
        return $data;
    }
    $lock_key = $key . '_lock';
    if (wp_cache_add($lock_key, 1, 'catalog', 30)) {
        // Только этот процесс пересчитывает
        $data = expensive_category_query($term_id);
        wp_cache_set($key, $data, 'catalog', 15 * MINUTE_IN_SECONDS);
        wp_cache_delete($lock_key, 'catalog');
        return $data;
    }
    // Остальные ждут до 3 секунд и читают готовое
    for ($i = 0; $i < 30; $i++) {
        usleep(100000);
        $data = wp_cache_get($key, 'catalog');
        if (false !== $data) {
            return $data;
        }
    }
    // Совсем крайний случай — считаем сами
    return expensive_category_query($term_id);
}
Третья: прогрев кэша после любых изменений — ноль. Мы включили кэш за три дня до распродажи и ушли довольные. Ни один скрипт не ходил по основным категориям и не прогревал ключи. Когда пришла рассылка, кэш был полупустой, и пиковый трафик попал на «холодные» страницы, которым ещё и мешало вытеснение. Теперь в чек-листе любого включения кэширования есть обязательный шаг: прогрев топ-50 URL по данным Метрики сразу после настройки и после каждой инвалидации.
Почему именно volatile-lru, а не другие политики
Короткий ликбез, потому что в тот день я сам выбирал политику наугад из шести вариантов в документации Redis. Политика вытеснения решает, какие ключи Redis удалит, когда упирается в maxmemory. allkeys-lru вытесняет самые давно неиспользуемые ключи вообще — включая вечные транзиенты со скидочными правилами, что и произошло у нас. volatile-lru вытесняет только ключи, у которых задан TTL: временные кэши страниц и запросов умирают первыми, а вечные ключи не трогаются никогда. Есть ещё volatile-ttl — вытесняет ключи с наименьшим оставшимся временем жизни, тоже рабочий вариант для объектного кэша.
А вот noeviction для WooCommerce я бы не брал: Redis просто начнёт возвращать ошибку на запись, когда кончится память, и плагин кэширования должен уметь это переживать. Redis Object Cache умеет, но я видел самописные прослойки, которые в этой ситуации роняли сайт надёжнее любого stampede.
Как поднимали за 40 минут
Хронология восстановления, может пригодиться как регламент. 11:47 — алерт и звонок. 11:52 — отключили Redis Object Cache (удаление object-cache.php из wp-content), сайт ожил на прямых запросах к базе, медленный, но живой. 12:05 — перевели страничный кэш на файловое хранилище, чтобы главная и категории снова отдавались мгновенно. 12:15 — подняли Redis с maxmemory 512mb, volatile-lru и отдельной базой под объектный кэш. 12:25 — прогрели топ-50 URL curl-скриптом. 12:27 — нагрузка на базу упала до нормальной, распродажа продолжилась. Потери — примерно 40 минут простоя и часть утренней волны трафика.
Чем всё закончилось и что я делаю иначе теперь
Итоговые цифры после правильной настройки: TTFB категорий 0,4–0,5 секунды под нагрузкой, hit ratio объектного кэша 96%, ни одного вытеснения вечных ключей за месяц наблюдений. Но главное не цифры, а изменение процесса. Теперь любое изменение в слое кэширования я выкатываю только с четырьмя вещами: лимит памяти и политика вытеснения в конфиге, защита от stampede на тяжёлых ключах, скрипт прогрева и нагрузочный тест хотя бы в 100 параллельных запросов на стейдже. Без последнего пункта «работает на моих трёх вкладках» не считается проверкой вообще.
Отдельно скажу про хостинг: если бы это был shared вместо VPS, половина этих шагов была бы просто недоступна — и это один из аргументов, почему магазинам с трафиком я рекомендую нормальную инфраструктуру. Кстати, вся эта история держалась на VPS в Docker — стек похож на тот, что я описывал в статье про WordPress в Docker с Nginx, PHP-FPM и MariaDB, и наличие изолированных контейнеров заметно упростило откат.
И ещё одна связка: после восстановления мы прогнали сайт через фронтенд-оптимизацию, которую я подробно разбирал в кейсе ускорения WordPress с 4,2 до 1,3 секунды — бэкенд-кэш и фронтенд-метрики работают вместе, по отдельности каждый даёт только половину результата. А чтобы о проблемах узнавать от мониторинга, а не от клиента, я ставлю те же контроли, что описывал в статье про передачу заявок в CRM — heartbeat-проверки отлично ловят и деградацию кэша.
Случалось ли вам ловить cache stampede или «ускоряться» до состояния лежащего сайта? Как защищаете тяжёлые пересчёты на своих проектах — блокировки, прогрев или что-то своё?
